Featured Project
Resume Copilot
基于项目知识库 RAG + 自研 ReAct Agent 的求职全流程助手
- 我的角色
- 独立开发者(产品定义 / 全栈实现 / 评测体系)
- 周期
- 2026.08 — 至今
- 规模
- 24,239 行 · 201 文件 · 4 大功能模块
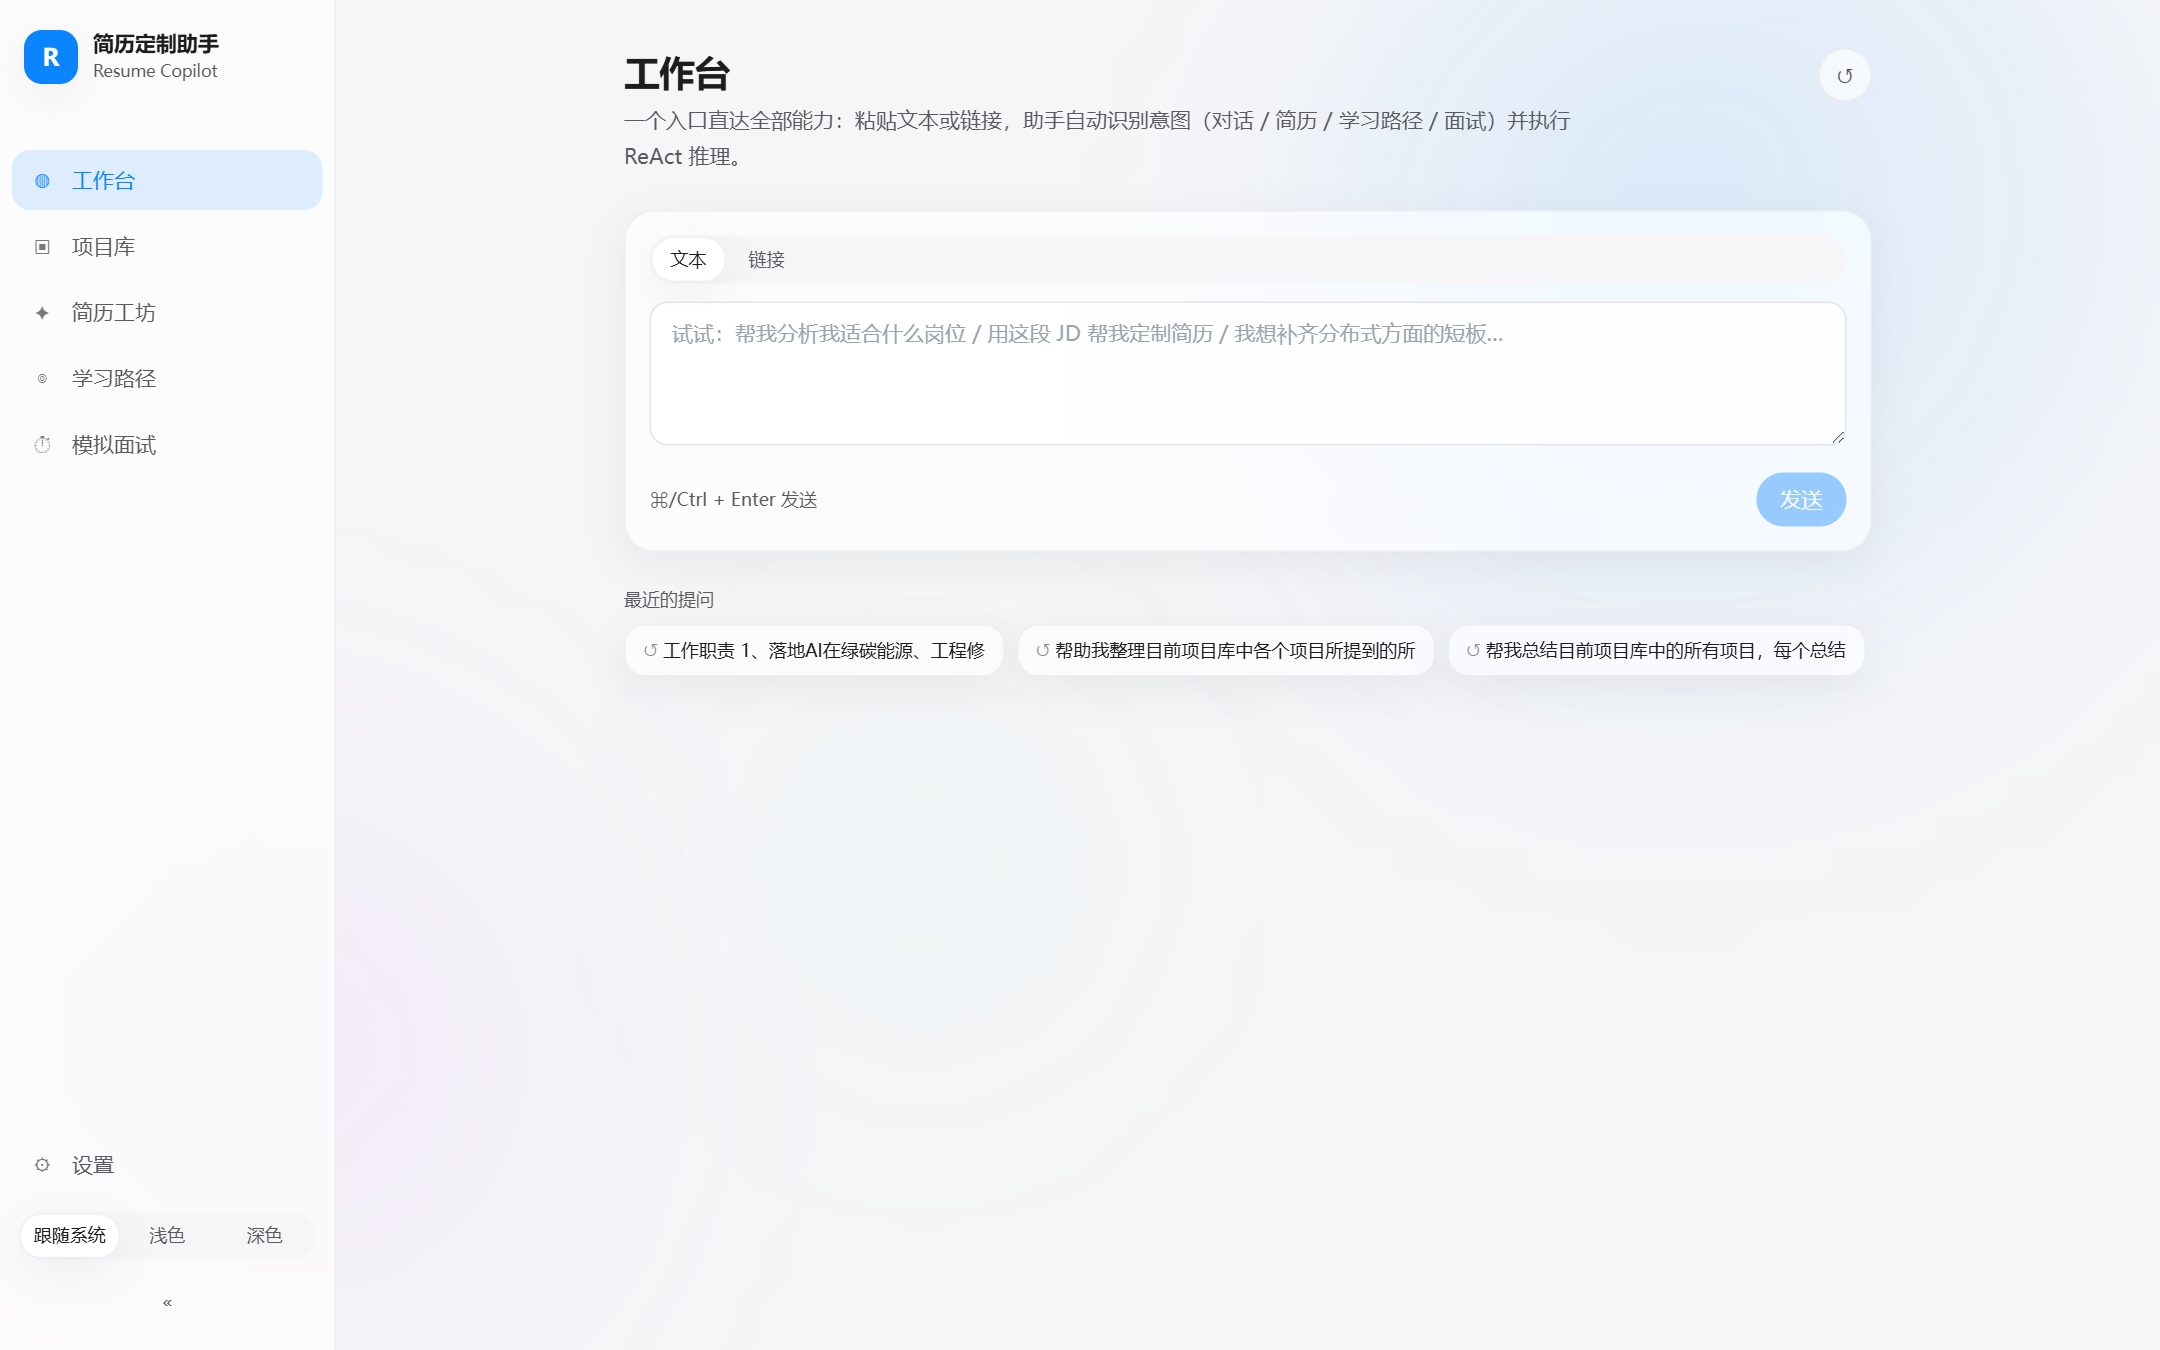
不是「帮你写简历」,而是「从你的真实项目里提取最有说服力的部分」:所有写入简历的数字经过工具层机器校验,无出处数字一律拒收。我先建评测体系,再让功能在数据面前接受审判。
§问题:AI 写简历的最大风险不是写得差,而是编得像
求职者最痛的不是简历模板,而是把自己做过的项目讲不清楚、讲不出数字。直接让 LLM 润色简历,输出看似专业,但数字、指标、技术细节全靠模型编造——面试官一追问就穿帮,这比写得平庸危险得多。
我的切入点:把「我做过什么」沉淀为可检索的项目知识库,让模型只允许引用知识库里有出处的内容,并用工程手段强制执行这条规则。
§方案:知识库 RAG + 自研 ReAct 引擎 + 机器门禁
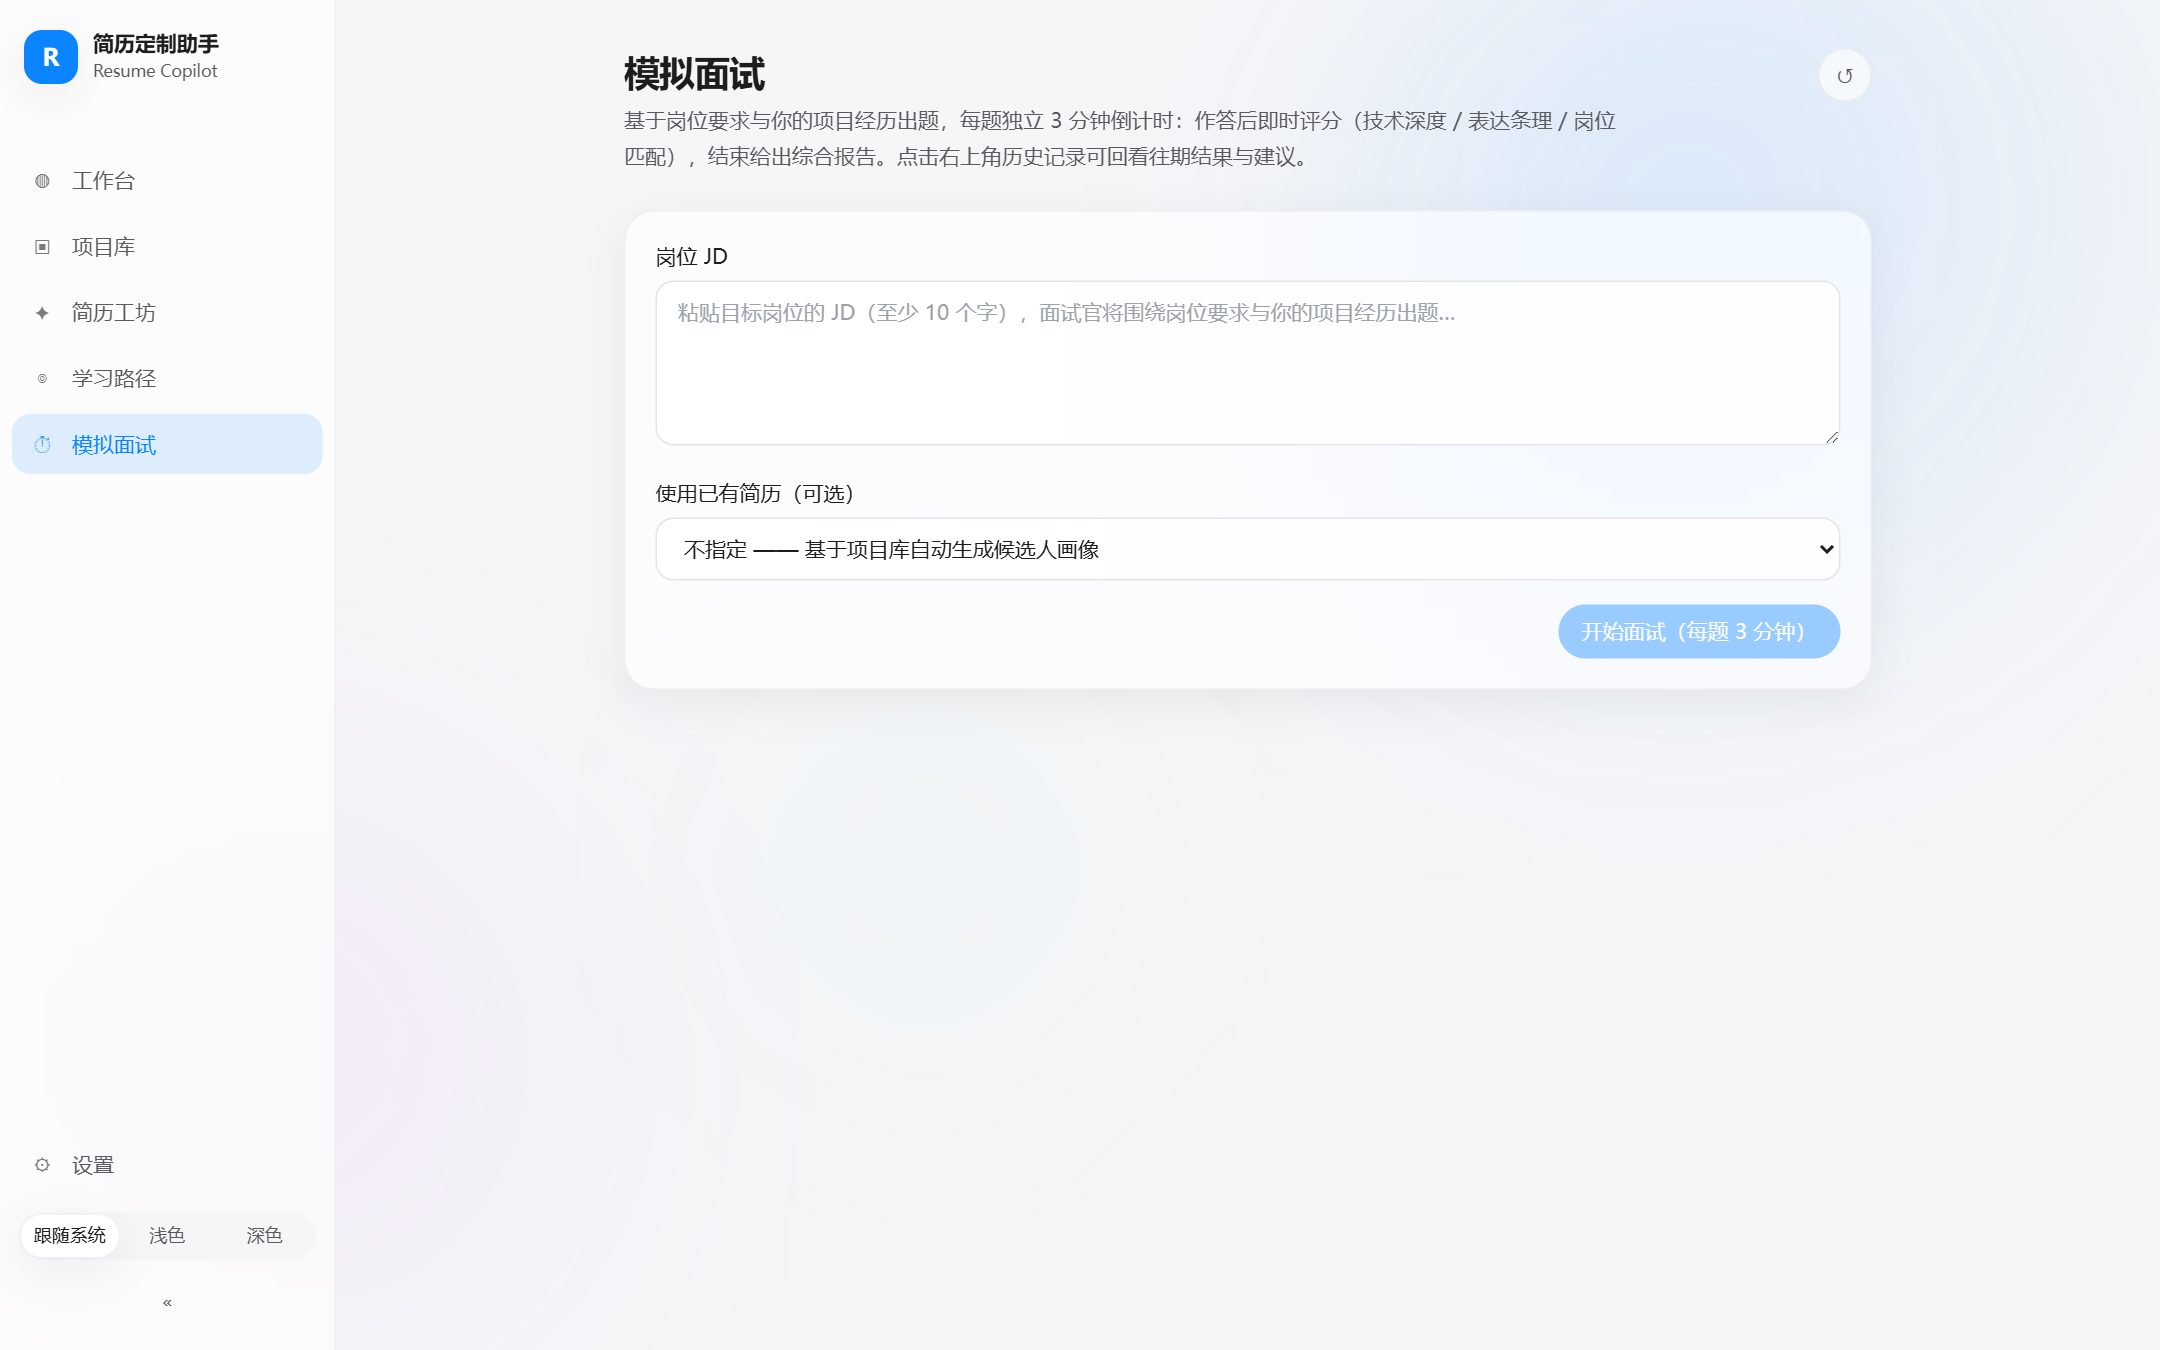
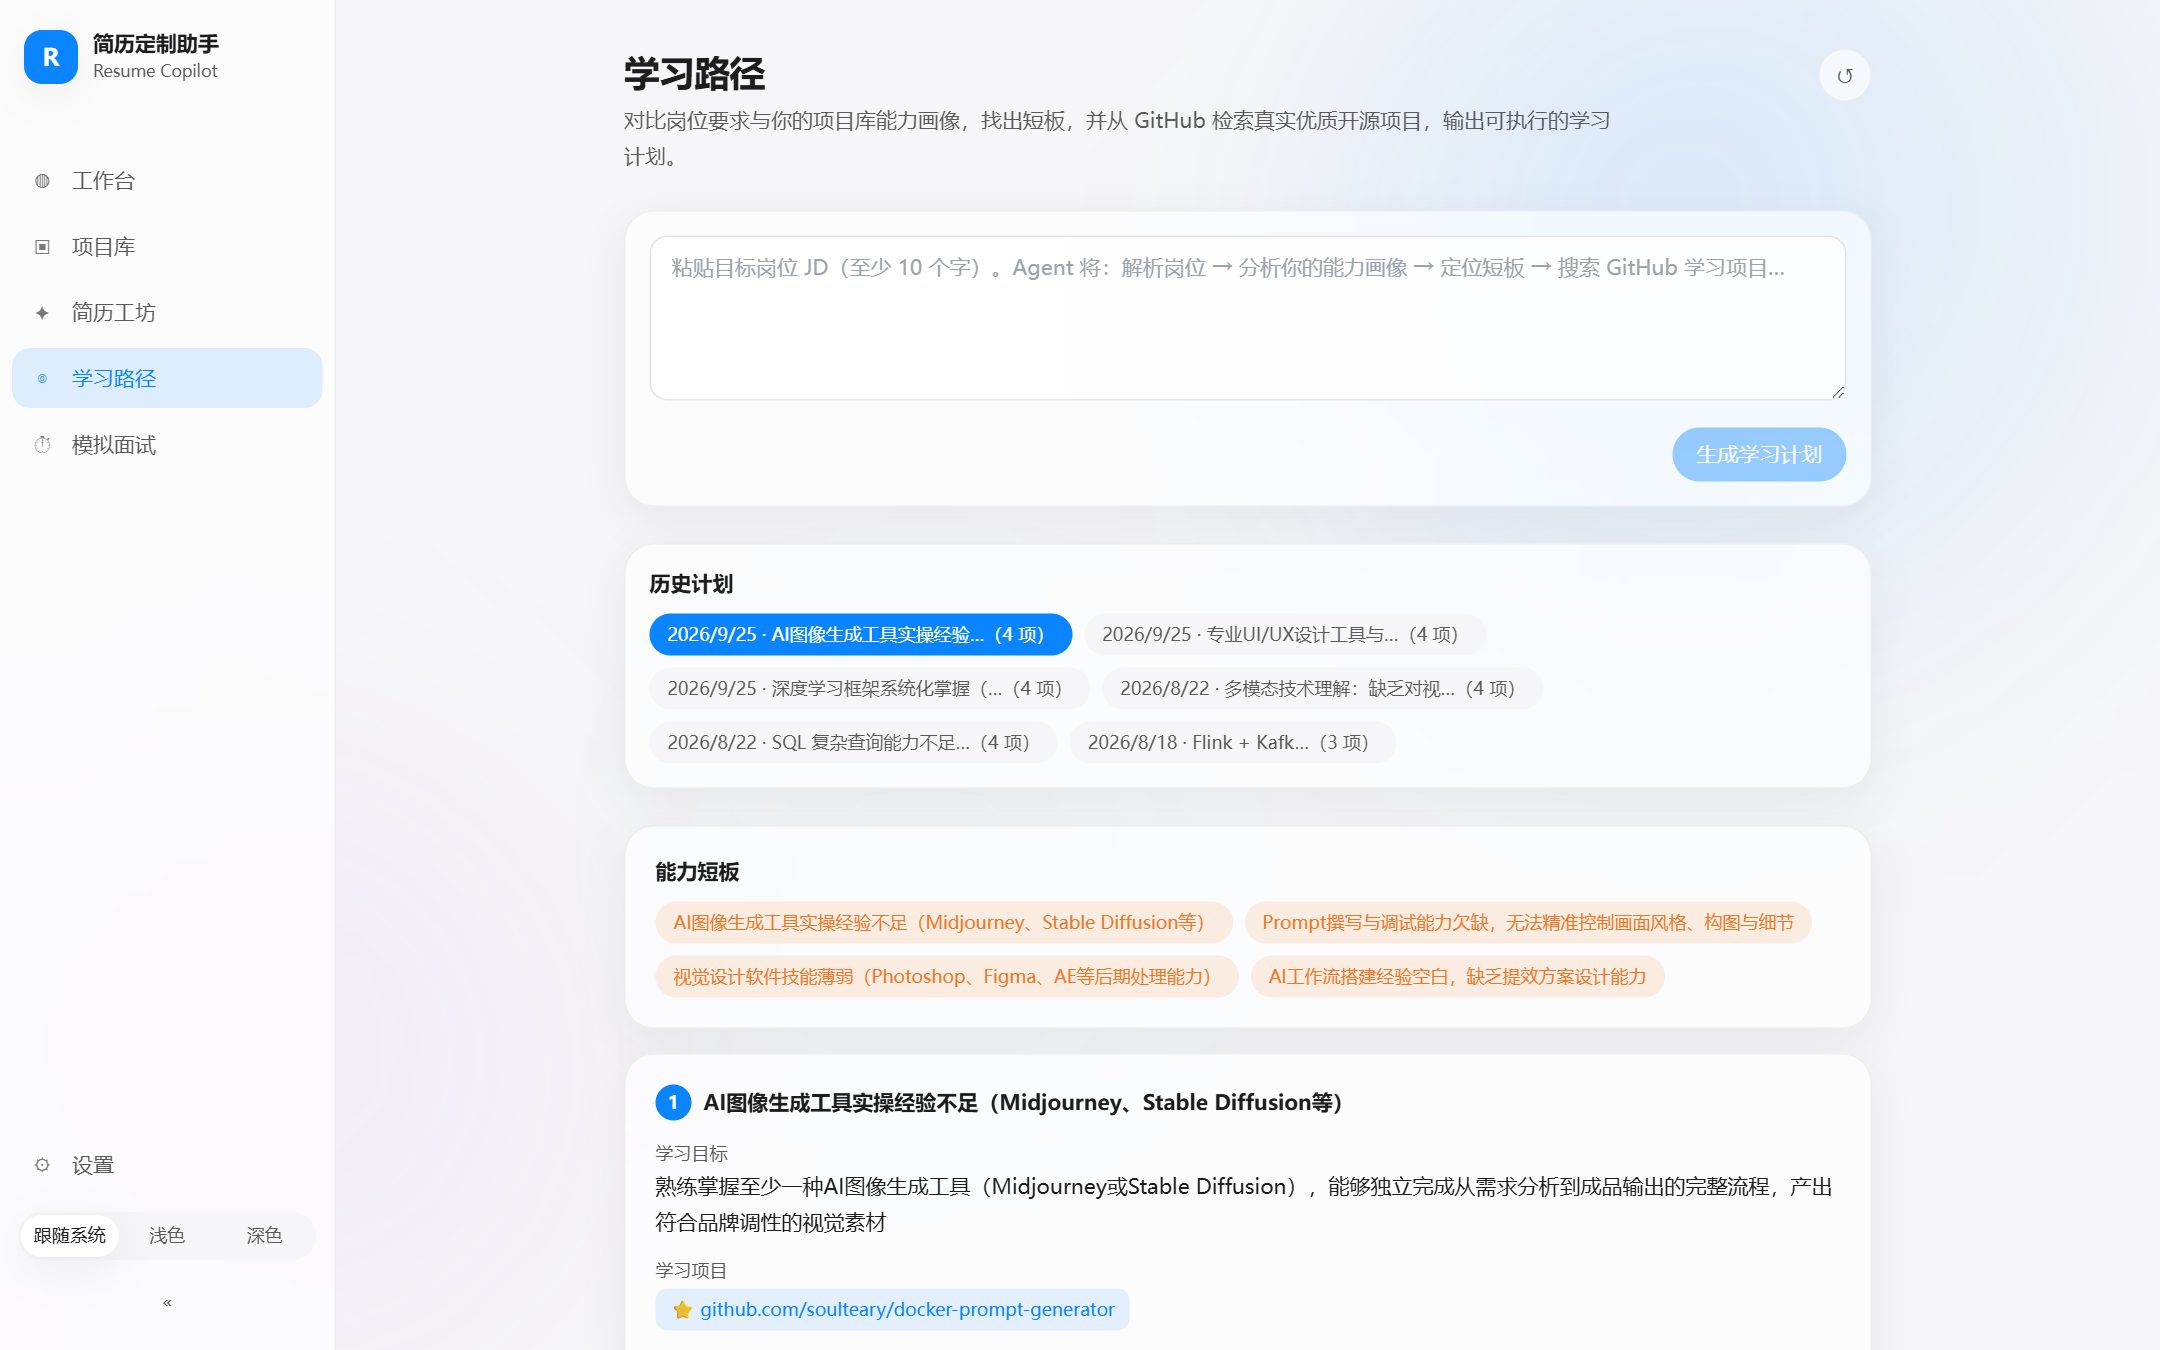
上传项目文档后建立 Qdrant 向量知识库;四大功能(简历生成 / 学习路径 / 模拟面试 / 投递预览)由自研 ReAct 引擎驱动:模型自主思考、选择工具、执行并收敛。
核心差异化是「可信度工程」:写入简历的每一个数字都必须携带知识库出处,工具层拒收无出处数字——编造率从机制上归零,而不是靠 prompt 恳求。
§评测体系:先建裁判,再做功能
四层评测体系覆盖业务、系统能力、安全、模型横评:52 条探针(幻觉 10 / 注入 12 / 隐私 10 / 合规 20)、45 份人工标注面试答案、15 份简历评分样本,产出 22 份评估报告。
评估发现问题 → 定位根因 → 修复 → 复测转绿的完整闭环沉淀为 26 条错误档案。跨 5 个模型的红线筛选让编造率越线的模型直接出局。
- 简历评估:FR 编造率 0.000,82/82 数字可溯源
- 面试评估:跨评分者一致性 ρ=0.891(基于 45 份黄金标注)
- 安全评估:幻觉 / 提示注入 / 隐私泄露 / 合规四组探针全部通过
- 性能评估:本机 P99 264ms,SQLite 只读 4,700+ RPS
§工程化:从代码到上线生效
pnpm monorepo 三包结构(api / web / shared zod 契约);Docker 三阶段多阶段构建,nginx 托管前端并反代 SSE;配套只读「上线生效性复核」脚本,避免「代码已合并但没上线」被误判为功能缺陷。
16 个 spec 单测文件 144/144 通过;10 份模块测试文档 + 15 个可执行测试脚本(冒烟 / 压测 / 故障注入 / 生产复核)。
§诚实的边界
最大的缺口在用户侧证据:没有真实用户与访谈,用「自用工具 + 补救计划」的诚实框架处理。投递模块刻意只保留 preview / mock——外部不可逆动作必须预览,这本身是产品敬畏心,也是安全红线。
§操作演示
§界面速览
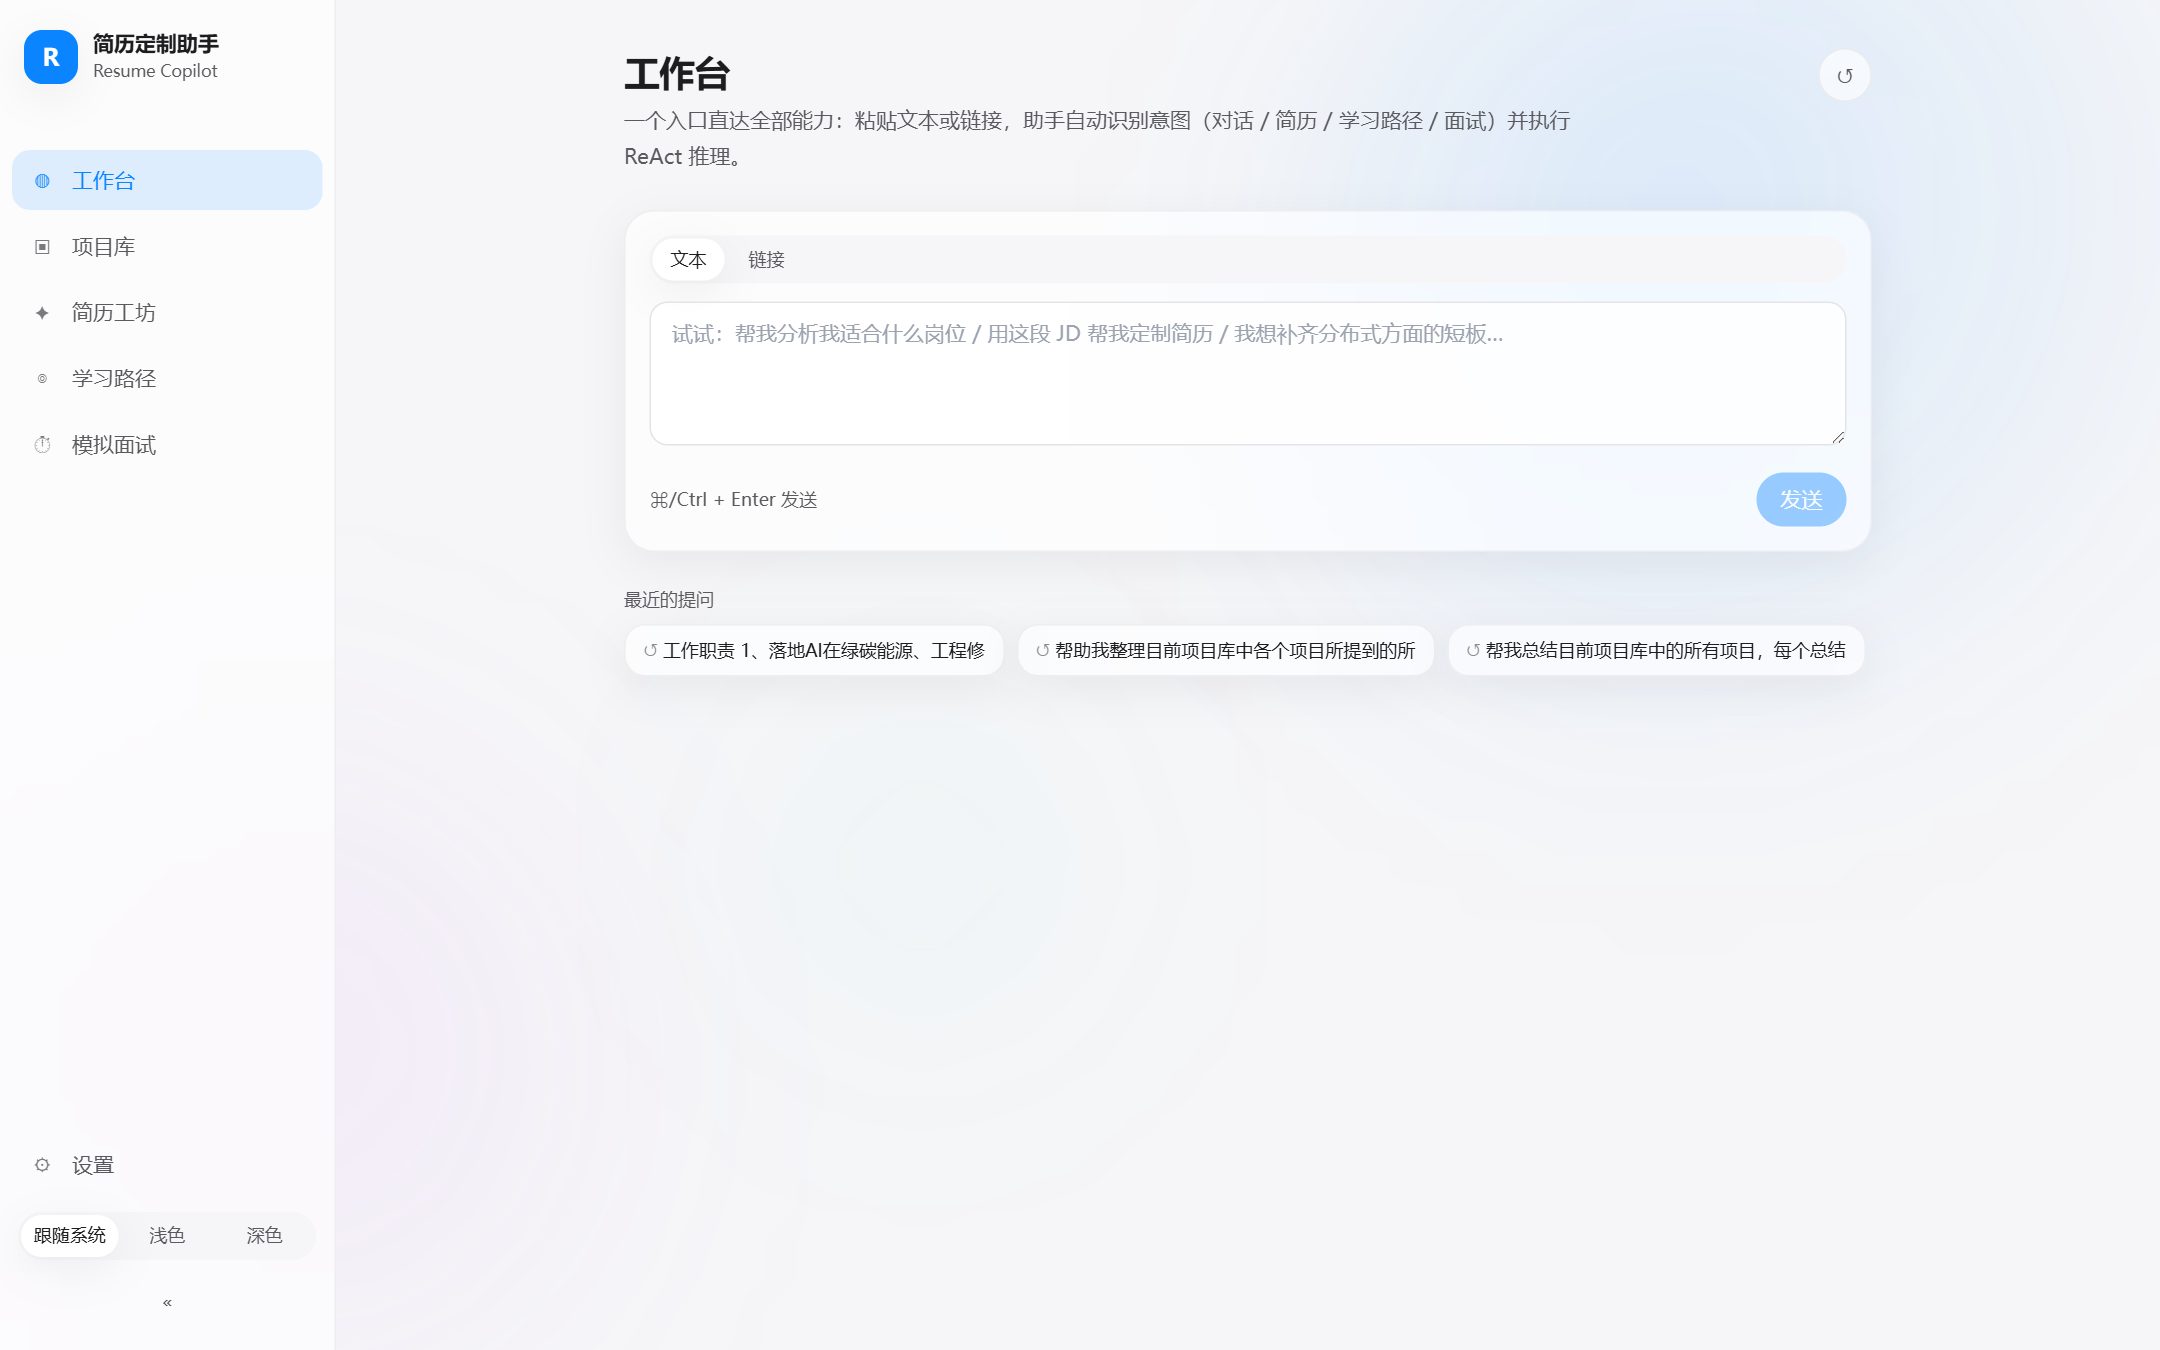
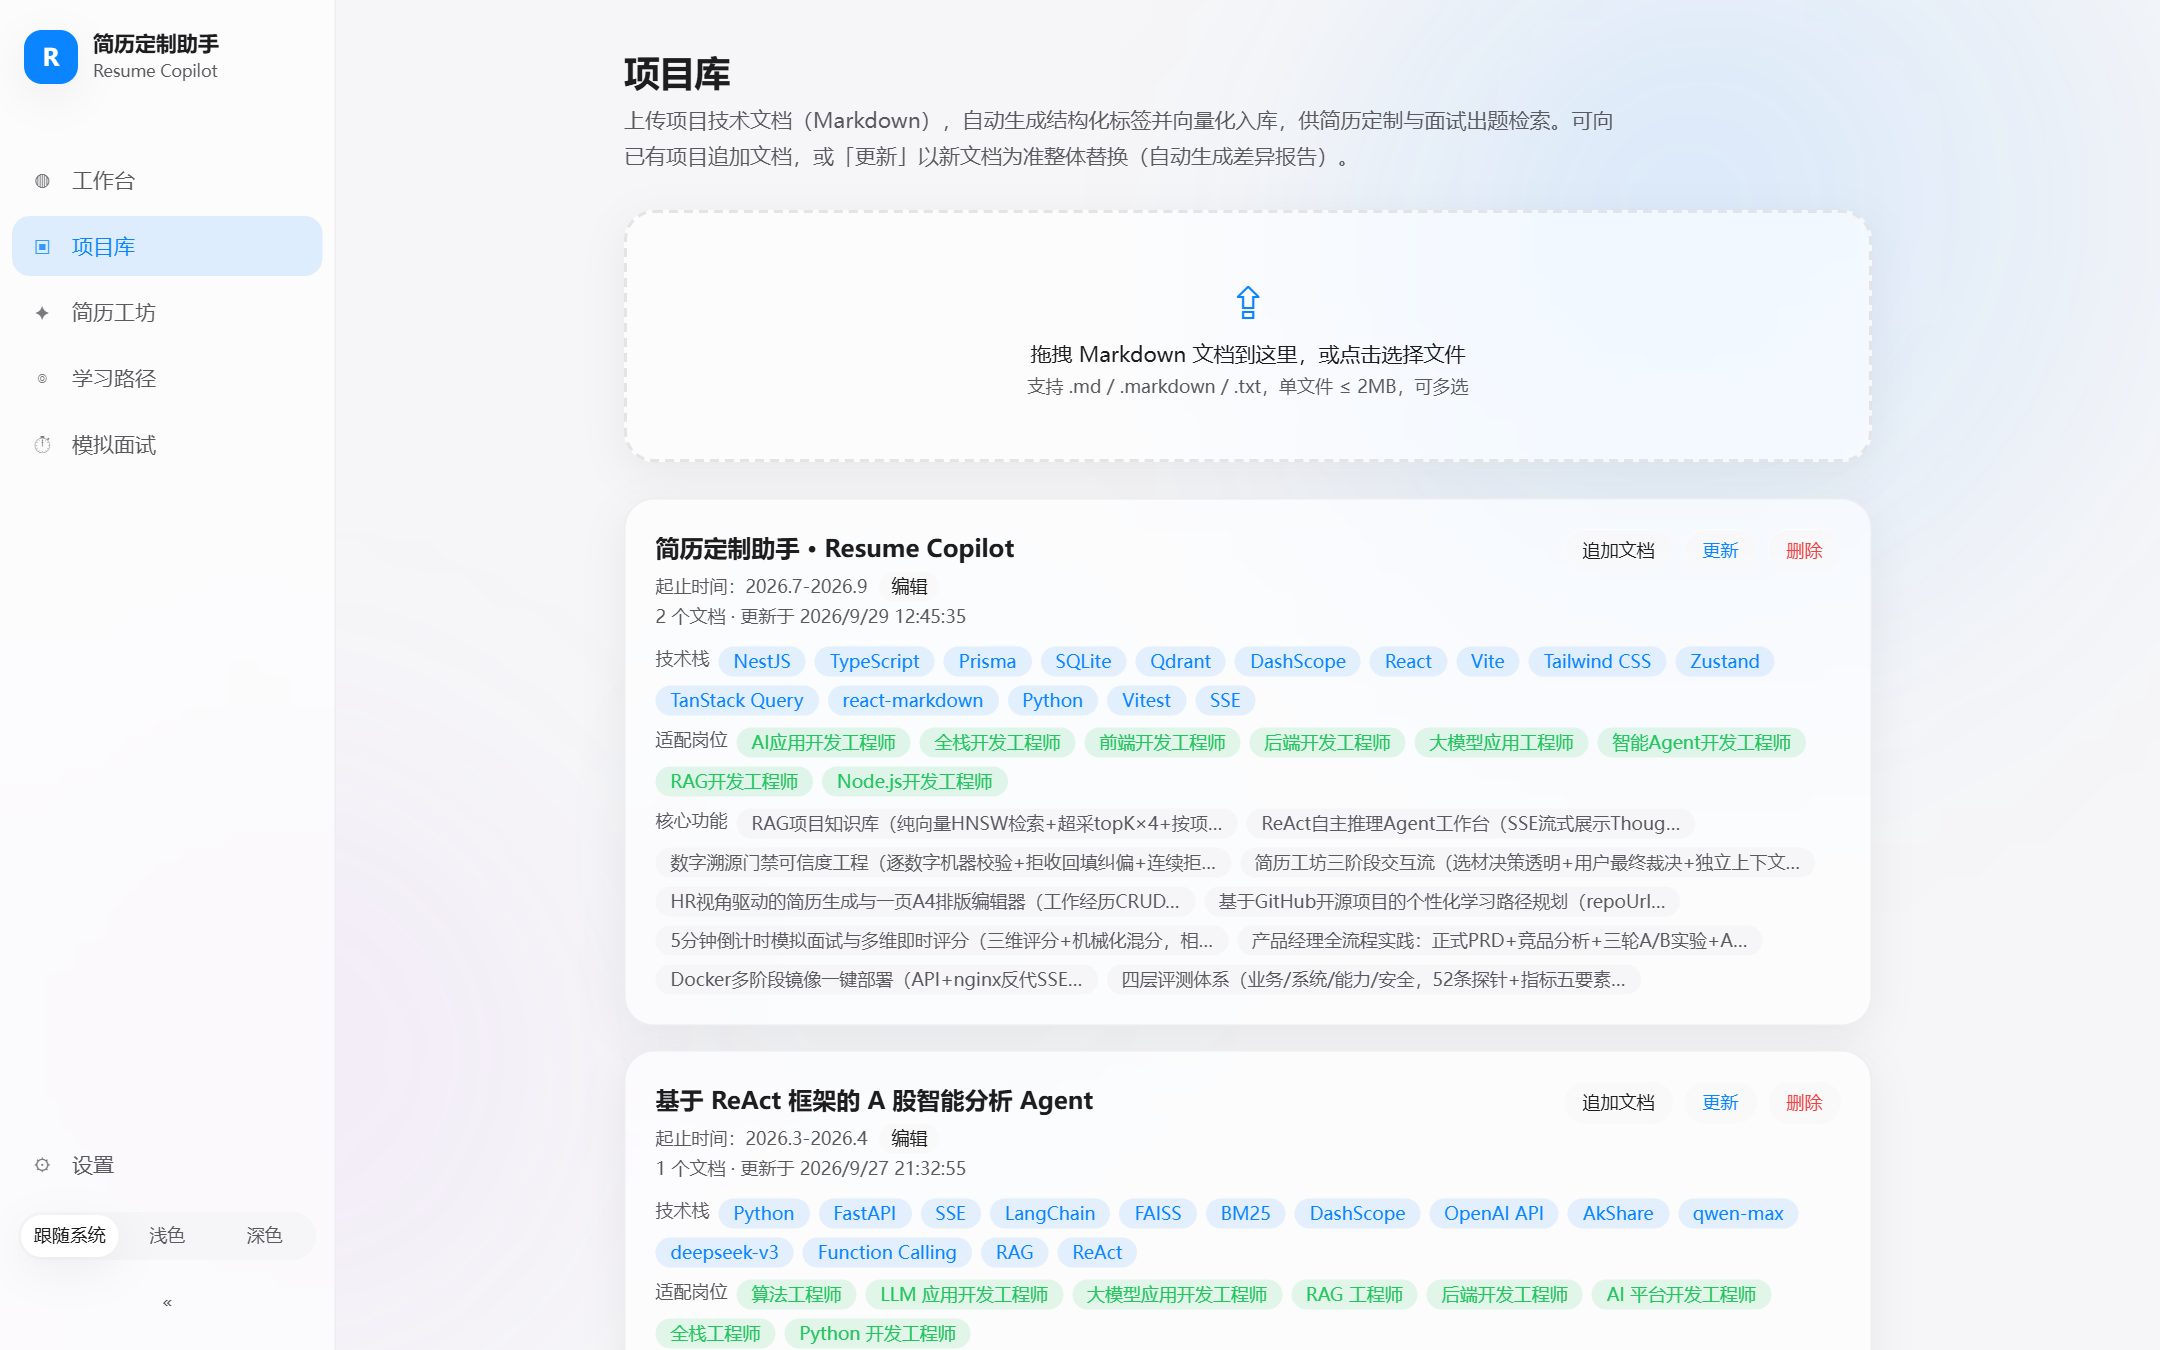
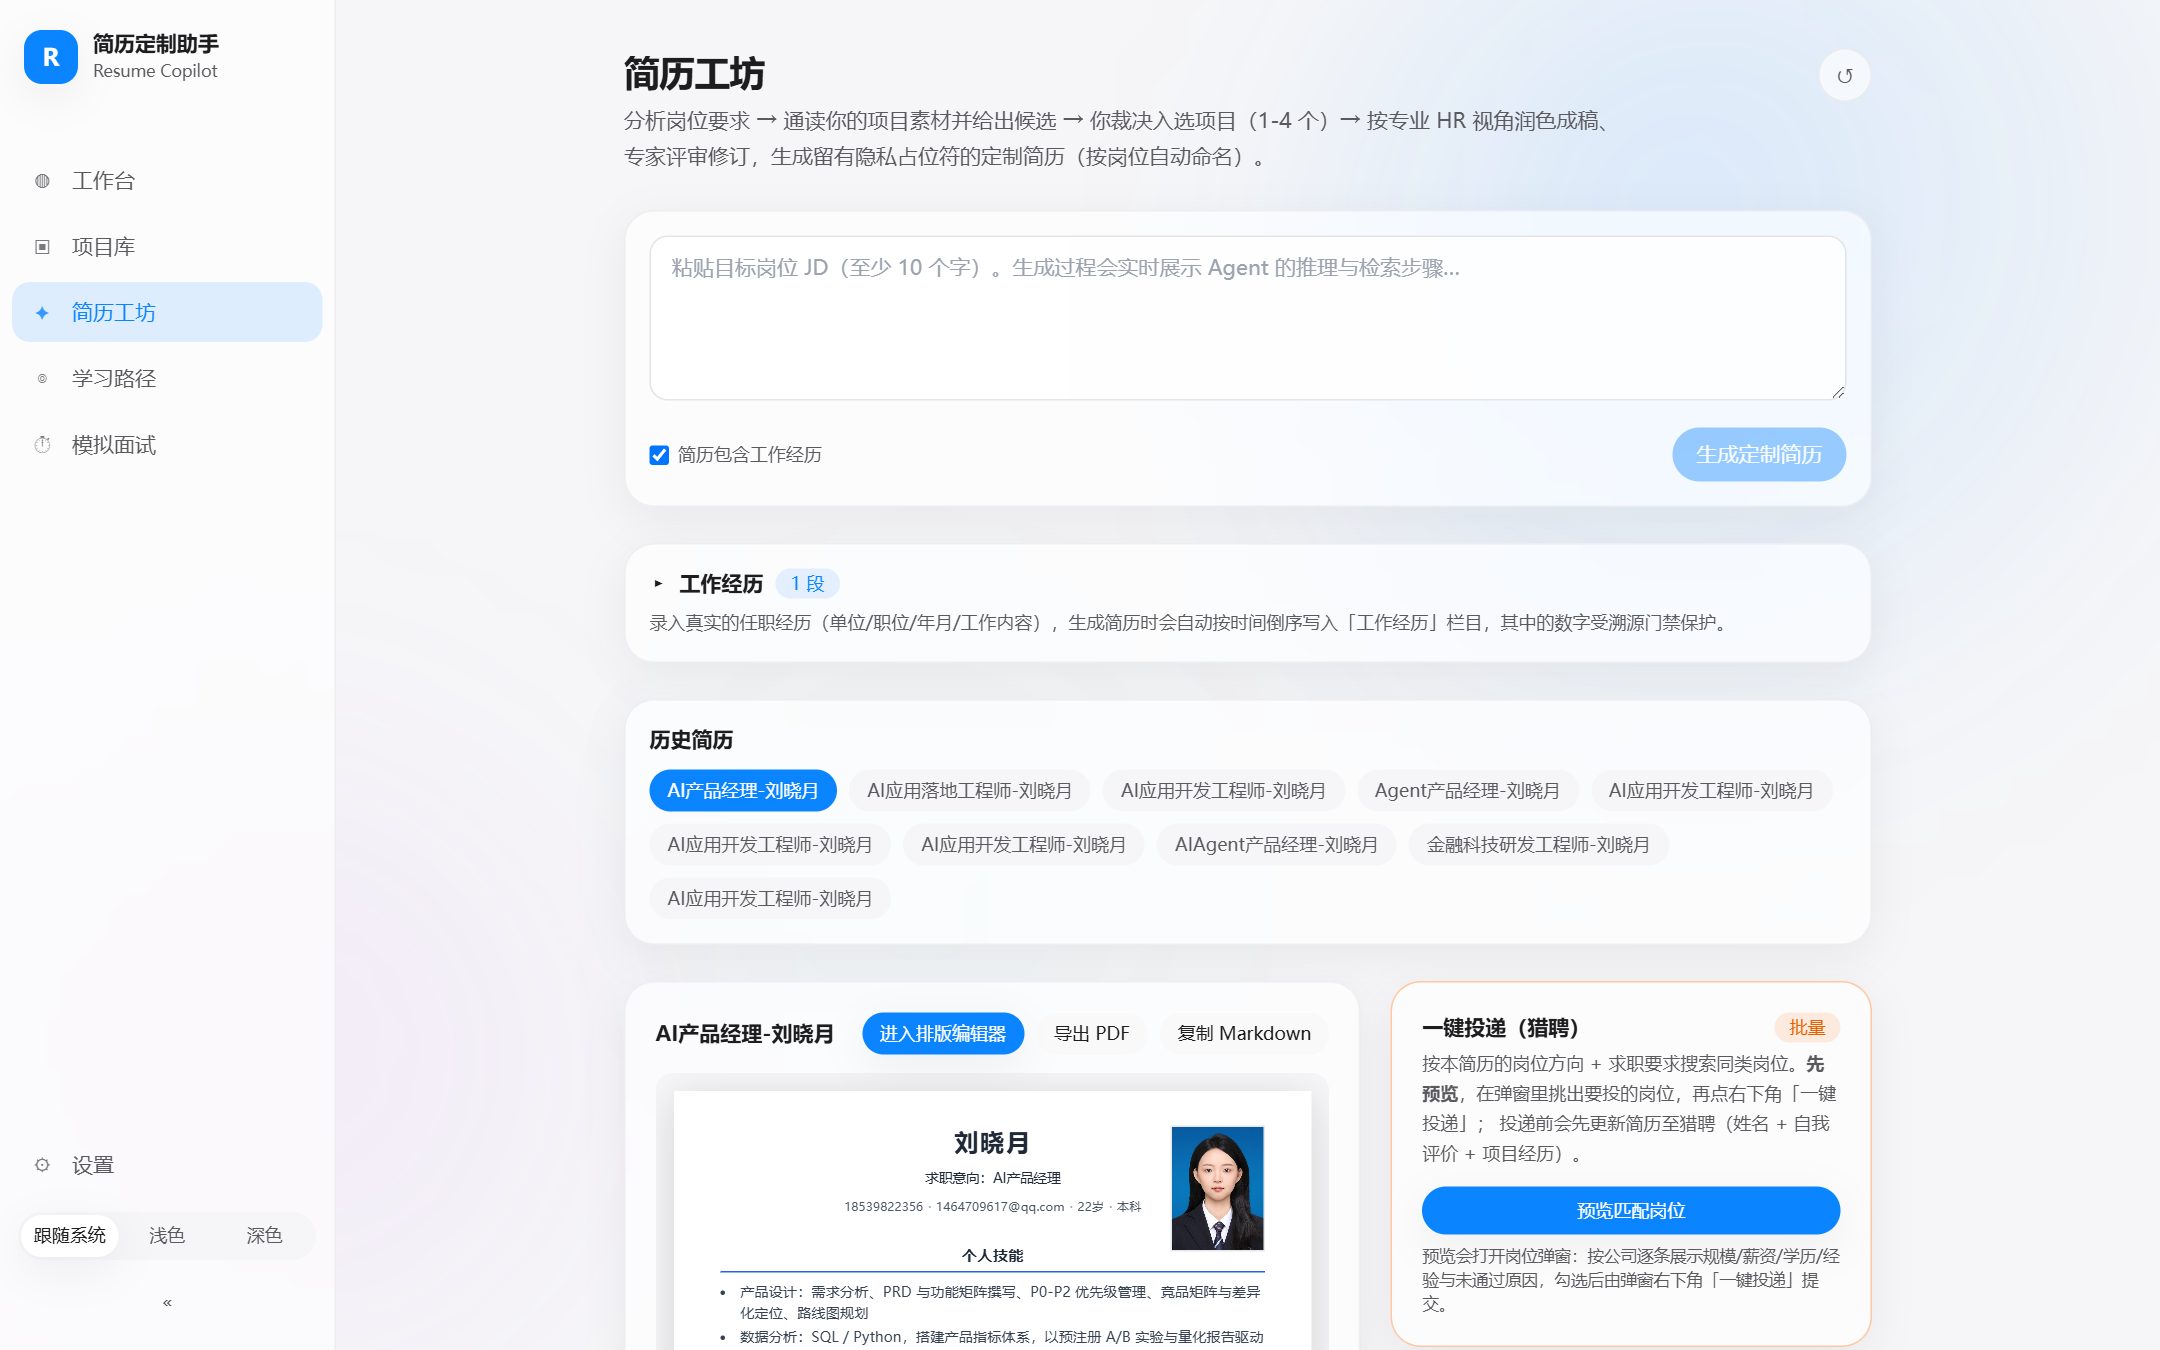
§难点与取舍
为什么自研 ReAct 而不用框架
需要把 token 记账、工具白名单、出处校验收口在引擎层,框架的黑盒扩展点满足不了机器门禁的可审计要求。
为什么投递模块不真投
外部不可逆动作必须 preview/mock。面试考察的是决策质量而非规模,把时间预算押在评测体系上。