基于自建书库的私人思维教练:EPUB 摄取 → 零 LLM 段落检索 → 两级教学规划 → 苏格拉底式对话。62 项断言的 e2e 用 Mock LLM 全链路跑通,不花一分钱 API 费也能回归。
§问题:把书读完不等于想清楚
读了很多书,遇到真实决策还是不会用——缺的不是知识输入,而是一个逼你把推理说出口、再追问漏洞的对象。市面 AI 问答工具倾向直接给答案,恰好剥夺了思考过程。
产品原则:不给答案,只给更好的问题;评分量规公开(PRD 6.3),让「问得好不好」可度量。
§方案:书库摄取 → 检索 → 两级规划 → 教学循环
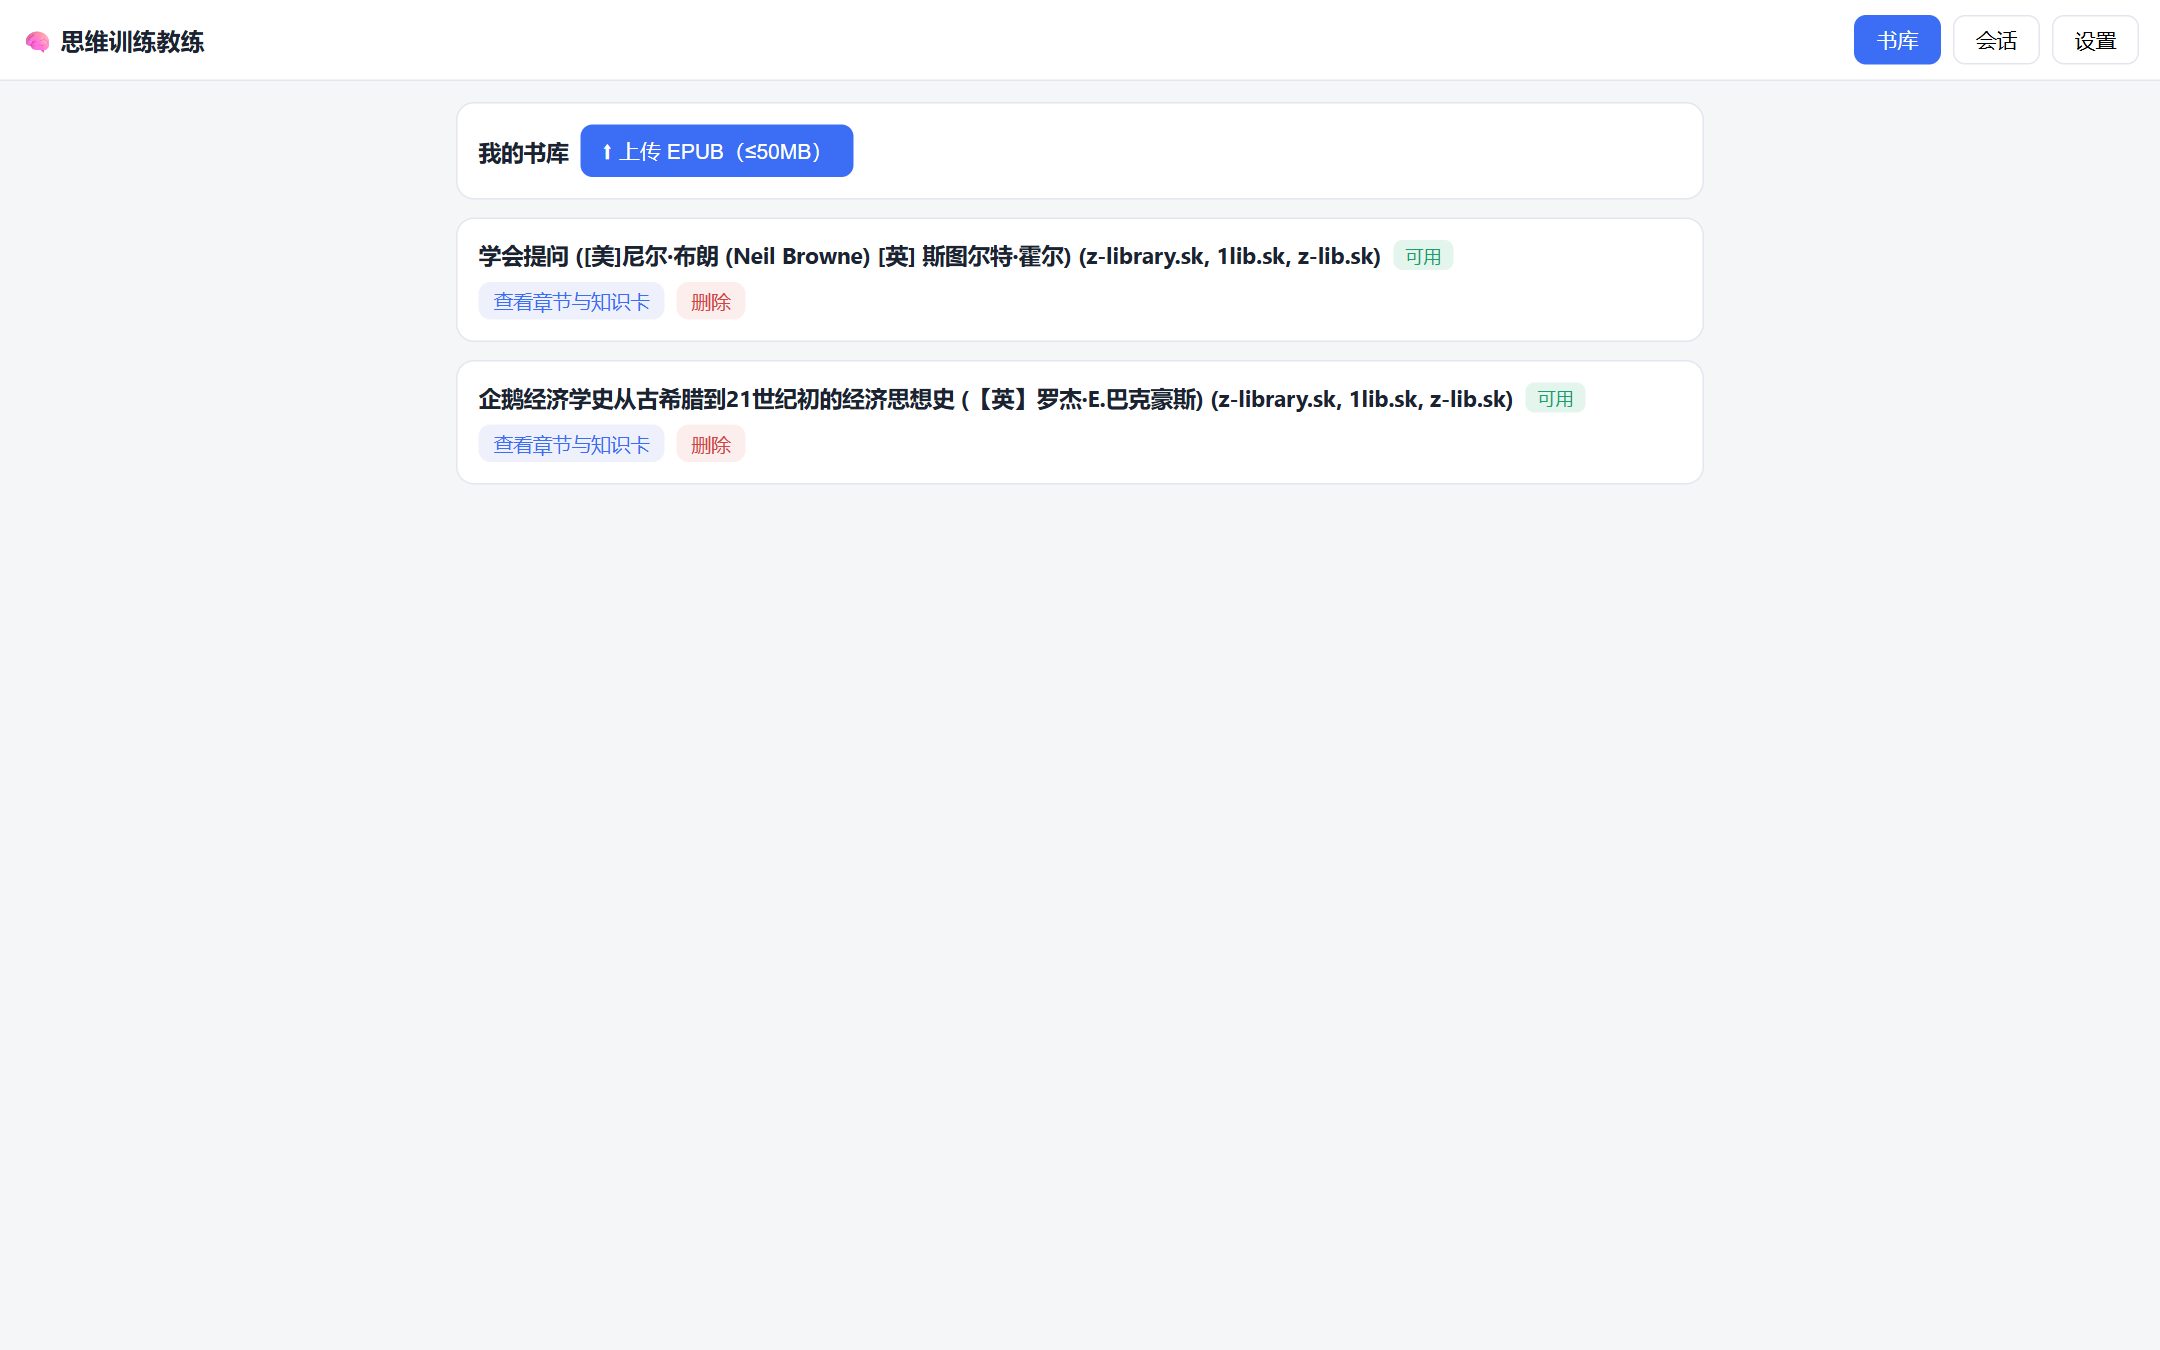
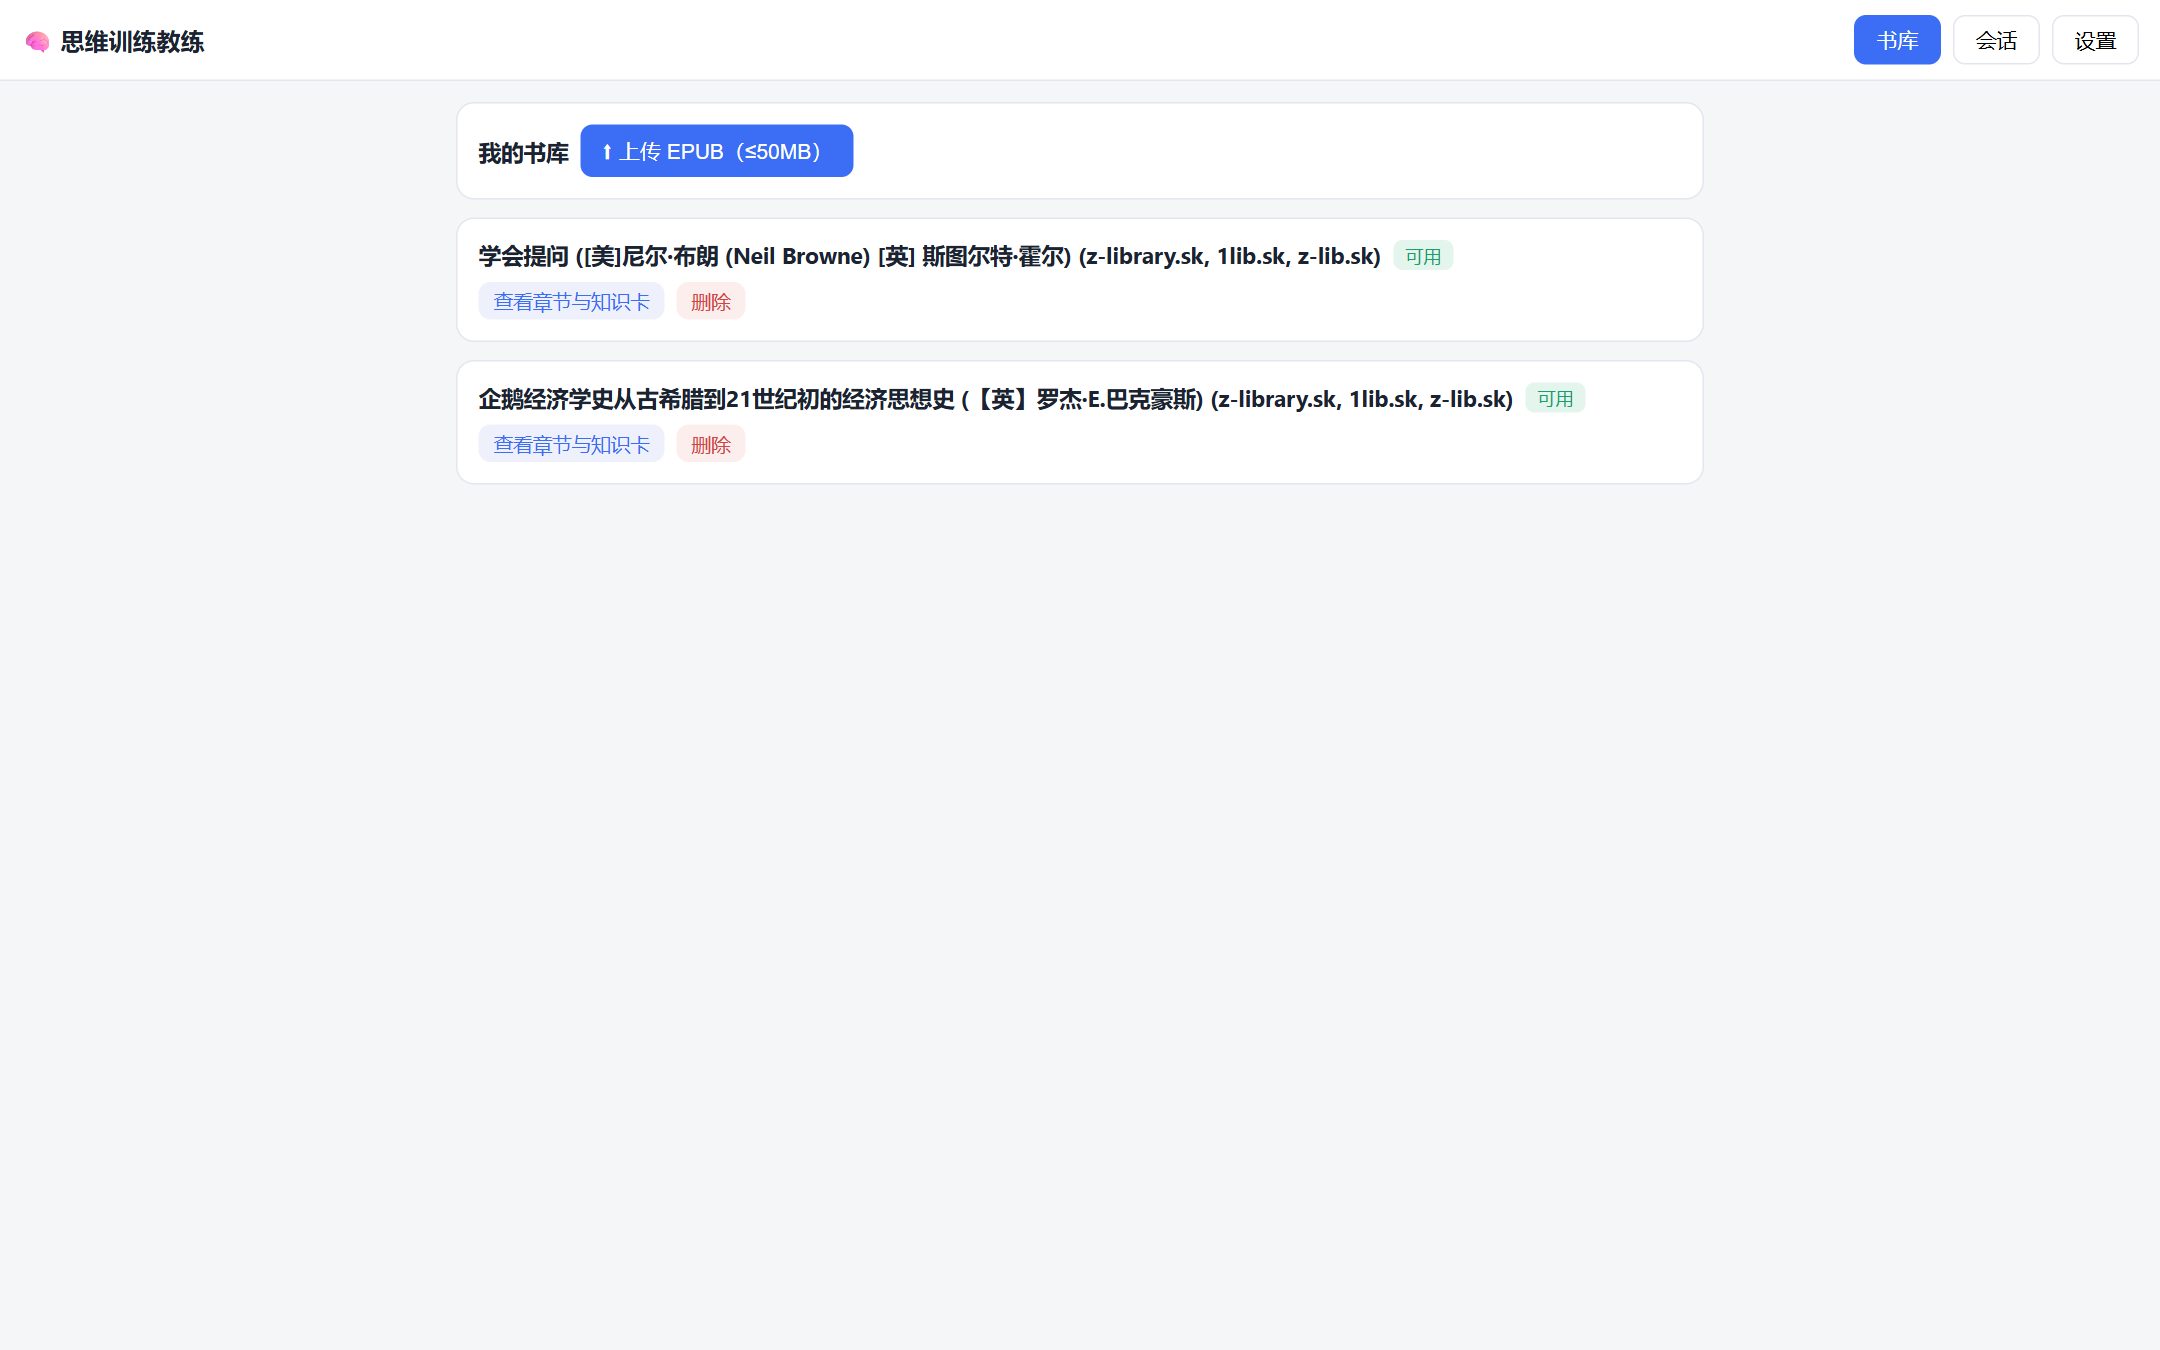
EPUB 摄取管线(NCX/nav 父子分块 + OCR 清洗)建自建书库;检索层完全不用 LLM(段落级零成本检索);教学层由两级规划(17.7KB plan.py)驱动 595 行教学状态机,控制追问节奏与收敛条件。
LLM 层收口在 llm.py 单点:token 记账、超时、重试统一管理。62 项断言的 e2e 基于自研 Mock LLM 服务全链路跑通——架构解耦让「教学逻辑正确性」与「模型效果」可以分开验证。
§PRD 先行:32KB 的产品思考
PRD v0.12 共 11 大节:用户画像、评分量规、质量评测指标、A/B 灰度方案、章级会话与两级规划的拍板记录。开发前的产品思考密度,是这个项目区别于「调 API demo」的关键。
§界面速览
§难点与取舍
为什么检索层零 LLM
段落检索是确定性工作,用 LLM 做检索既慢又贵还引入不确定性;LLM 只花在对话与规划上。
为什么用 Mock LLM 做 e2e
教学状态机的回归测试需要确定性与零成本;模型效果由真实调用另测,两条线不混。
§接下来
流式输出(M2)Docker 打包学习曲线可视化